O conhecimento pode ser o ativo mais valioso e mais desperdiçado de uma empresa
Imagine uma empresa com dez anos de operação.
Durante esse período, ela acumulou milhares de e mails, propostas comerciais, contratos, apresentações, documentos técnicos, planilhas, manuais, reuniões, conversas, procedimentos, atendimentos de clientes e decisões importantes.
Existe uma quantidade enorme de conhecimento ali.
O problema é que boa parte dele está espalhada.
Uma informação está no Google Drive. Outra está no CRM. Um procedimento importante foi escrito no Notion. Uma negociação está registrada no e mail. A solução para determinado problema técnico está escondida em uma conversa antiga. E algumas das informações mais importantes simplesmente permanecem na cabeça de funcionários experientes.
A empresa possui conhecimento.
Mas não consegue necessariamente acessá lo quando precisa.
Esse problema é muito maior do que parece.
Em um dos estudos mais conhecidos sobre o potencial econômico da inteligência artificial generativa, a McKinsey destacou que profissionais do conhecimento historicamente gastam uma parcela considerável do tempo procurando e reunindo informações. A consultoria vê na IA generativa uma oportunidade para transformar sistemas internos de conhecimento em verdadeiros especialistas virtuais, capazes de pesquisar grandes volumes de informações corporativas e entregar respostas em linguagem natural.
Veja o estudo da McKinsey sobre o potencial econômico da IA generativa
A transformação que está começando agora é justamente esta:
as empresas estão deixando de armazenar documentos para começar a construir conhecimento consultável por inteligência artificial.
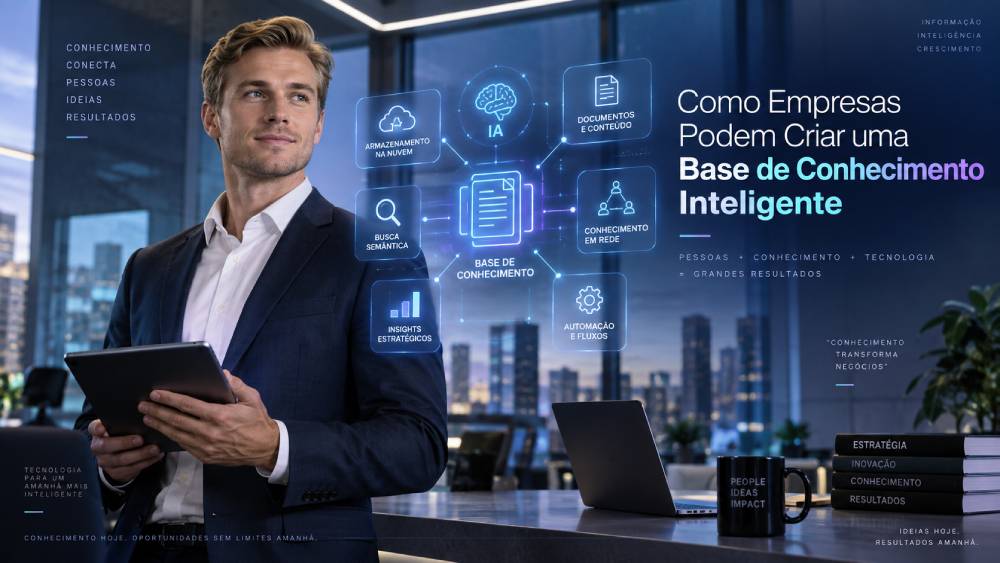
É o surgimento da base de conhecimento inteligente.
O que é uma base de conhecimento inteligente?
Uma base de conhecimento tradicional normalmente funciona como uma biblioteca.
Existem pastas.
Dentro das pastas existem arquivos.
Para encontrar uma informação, o funcionário precisa saber aproximadamente onde procurar ou utilizar palavras específicas em um mecanismo de busca.
Uma base de conhecimento inteligente funciona de maneira diferente.
Ela conecta documentos, sistemas, bancos de dados e outras fontes de informação a mecanismos capazes de compreender contexto, significado e intenção.
Em vez de pesquisar:
“política comercial cliente cancelamento 2025 PDF”
o funcionário poderia simplesmente perguntar:
“O que devemos fazer quando um cliente empresarial pede cancelamento antes do período mínimo do contrato?”
O sistema procura as informações relevantes, identifica documentos autorizados, compara as fontes e apresenta uma resposta baseada no conhecimento oficial da organização.
Idealmente, também mostra de onde retirou aquela informação.
Isso transforma completamente a relação entre pessoas e dados.
A Microsoft descreve essa arquitetura como uma camada de conhecimento capaz de conectar conteúdo corporativo a modelos de linguagem e agentes de inteligência artificial. Sistemas modernos podem combinar pesquisa textual, vetorial, multimodal e recuperação por agentes.
A AWS segue o mesmo princípio. Em sua documentação sobre RAG, explica que modelos podem consultar bases de conhecimento externas e confiáveis antes de gerar uma resposta, permitindo utilizar dados específicos da organização sem precisar treinar novamente todo o modelo.
Entenda como a AWS explica a geração aumentada por recuperação
Esse conceito muda a gestão do conhecimento empresarial.
Uma base inteligente não é apenas um chatbot corporativo
Existe um erro comum.
A empresa conecta alguns PDFs a uma inteligência artificial, cria uma janela de conversa e anuncia:
“Temos uma base de conhecimento com IA.”
Isso é apenas o começo.
Uma verdadeira base de conhecimento inteligente envolve diversas camadas.
Ela precisa saber:
onde está a informação, qual informação é mais confiável, quem pode acessá la, quando foi atualizada, qual documento substituiu outro, qual conteúdo é relevante para cada pergunta e quando o sistema deveria simplesmente responder que não sabe.
Portanto, o desafio não é apenas tecnológico.
É também organizacional.
A própria McKinsey publicou em 2026 uma observação extremamente relevante para empresas que desejam se tornar mais orientadas por IA: frequentemente o gargalo não está no modelo de inteligência artificial, mas no acesso ao conhecimento interno.
Informações importantes continuam presas em reuniões, conversas, sistemas isolados e na experiência de determinados profissionais. Quando esse conhecimento não é registrado e organizado, a IA simplesmente torna o problema mais visível.
Essa talvez seja uma das maiores mudanças na gestão empresarial dos próximos anos.
Quanto melhor estiver organizado o conhecimento da empresa, mais poderosa poderá se tornar sua inteligência artificial.
RAG: a tecnologia que conecta a IA ao conhecimento da empresa
Um dos conceitos centrais nessa transformação é chamado de Retrieval Augmented Generation, normalmente conhecido pela sigla RAG.
Em português, significa geração aumentada por recuperação.
O funcionamento básico é relativamente simples.
Quando alguém faz uma pergunta, o sistema não depende exclusivamente daquilo que o modelo de inteligência artificial aprendeu durante seu treinamento.
Primeiro, ele procura informações relevantes na base de conhecimento da empresa.
Depois, essas informações são fornecidas ao modelo como contexto.
Finalmente, a IA utiliza esse contexto para construir a resposta.
Segundo a IBM, essa arquitetura permite conectar modelos a documentos internos, dados especializados e informações atualizadas, reduzindo a dependência exclusiva do conhecimento original do modelo.
Veja a explicação da IBM sobre RAG
Isso resolve um problema importante.
Uma inteligência artificial pública pode saber muito sobre marketing, vendas ou legislação em geral.
Mas ela não conhece automaticamente:
os preços da sua empresa, seus contratos, seus clientes, seus procedimentos, suas decisões internas, suas políticas ou aquilo que aconteceu em uma reunião ontem.
RAG permite construir essa ponte.
Busca semântica: encontrar pela ideia, não apenas pela palavra
Outra tecnologia importante é a busca semântica.
Mecanismos tradicionais procuram principalmente palavras.
Uma busca semântica tenta compreender significado.
Imagine que um documento utilize a expressão:
“interrupção definitiva da prestação do serviço”
e o funcionário pergunte:
“como funciona o cancelamento?”
Uma pesquisa baseada apenas em palavras poderia não perceber imediatamente a relação.
Uma pesquisa semântica consegue compreender que os conceitos podem estar relacionados.
Isso acontece, em parte, através de representações matemáticas chamadas embeddings.
Documentos e perguntas são transformados em representações numéricas. Conteúdos semanticamente semelhantes acabam posicionados próximos dentro desse espaço matemático.
Quando alguém faz uma pergunta, o sistema consegue procurar conteúdos semelhantes em significado, mesmo que utilizem palavras diferentes.
É aí que entram os bancos vetoriais e mecanismos de pesquisa vetorial.
A arquitetura recomendada pelo Google Cloud para aplicações RAG inclui justamente serviços de pesquisa vetorial capazes de localizar informações semanticamente relacionadas em grandes volumes de dados.
Nas arquiteturas mais sofisticadas, empresas podem combinar:
busca por palavras + busca semântica + filtros + contexto + classificação por relevância.
Esse modelo é conhecido como busca híbrida.
Knowledge Graph e GraphRAG: quando documentos começam a criar relações
Existe uma etapa ainda mais avançada.
Suponha que uma empresa tenha os seguintes elementos:
Cliente A
Contrato B
Produto C
Vendedor D
Projeto E
Chamado técnico F
Uma base comum pode armazenar todos esses documentos.
Um grafo de conhecimento procura compreender também as relações entre eles.
O Cliente A possui o Contrato B.
O Contrato B inclui o Produto C.
O Vendedor D gerencia a conta.
O Projeto E está relacionado ao Produto C.
O Chamado F ocorreu durante o Projeto E.
A inteligência passa a enxergar não apenas documentos, mas relações.
O Google Cloud já apresenta arquiteturas chamadas GraphRAG, que combinam pesquisa vetorial com consultas em grafos de conhecimento para recuperar informações interconectadas e fornecer mais contexto às aplicações de IA generativa.
Isso pode ser extremamente poderoso.
Um diretor poderia perguntar:
“Quais clientes tiveram problemas semelhantes nos últimos 18 meses, quais produtos estavam envolvidos e quais soluções apresentaram melhor resultado?”
A IA poderia atravessar diversas fontes e relacionamentos antes de responder.
Estamos deixando a era da busca documental e entrando na era da inteligência corporativa contextual.
Como criar uma base de conhecimento inteligente na prática
A tecnologia é importante, mas o projeto deve começar pelo negócio.
Uma implementação eficiente pode seguir oito etapas principais:
- Escolher um problema concreto. Começar tentando organizar todo o conhecimento da empresa costuma gerar projetos enormes. É melhor iniciar com um caso de uso valioso, como suporte técnico, atendimento, vendas, onboarding, propostas ou documentação de produtos.
- Mapear as fontes existentes. Identifique onde está o conhecimento atual: Google Drive, SharePoint, Notion, CRM, ERP, banco de dados, PDFs, manuais, site, e mails, tickets, wiki, Slack, Teams e outras plataformas.
- Eliminar conteúdo inútil ou contraditório. Documentos duplicados, versões antigas e procedimentos abandonados reduzem a qualidade da recuperação. IA não transforma informação ruim automaticamente em conhecimento confiável.
- Criar metadados e classificação. Departamento, cliente, produto, data, proprietário, versão, confidencialidade e validade são exemplos de informações que ajudam o sistema a entender melhor os conteúdos.
- Construir a camada de recuperação. Aqui entram indexação, fragmentação de documentos, embeddings, pesquisa vetorial, pesquisa textual, classificação por relevância e eventualmente RAG ou GraphRAG.
- Implementar identidade e permissões. A IA deve respeitar as mesmas regras de acesso utilizadas pelos sistemas corporativos. Um funcionário não pode descobrir através do chatbot um documento que não deveria conseguir abrir diretamente.
- Conectar modelos e agentes. Depois que a camada de conhecimento funciona, diferentes modelos de IA e agentes podem consultá la para responder perguntas ou executar tarefas.
- Medir e melhorar continuamente. Perguntas sem resposta, fontes pouco utilizadas, respostas incorretas e avaliações dos usuários devem alimentar um ciclo constante de melhoria.
Essa última etapa é frequentemente ignorada.
Uma base inteligente não deve ser construída e abandonada.
Ela precisa aprender com a utilização da própria empresa.
Segurança e permissões precisam nascer junto com o projeto
Imagine conectar contratos, dados de clientes, documentos jurídicos, preços, informações financeiras e estratégias empresariais em uma única interface de inteligência artificial.
Sem governança, isso pode criar um problema enorme.
Por esse motivo, segurança não deve ser adicionada depois.
Ela deve fazer parte da arquitetura desde o primeiro dia.
Soluções modernas já caminham nessa direção. A Microsoft, por exemplo, descreve suas bases de conhecimento empresariais como estruturas capazes de reconhecer permissões, permitindo que agentes utilizem conteúdo corporativo respeitando controles de acesso.
Também é importante estabelecer políticas sobre quais dados podem alimentar modelos, quais respostas precisam apresentar fontes, quais ações podem ser executadas automaticamente e quais exigem aprovação humana.
O AI Risk Management Framework do NIST propõe justamente uma abordagem contínua de gestão de riscos durante o projeto, desenvolvimento, uso e avaliação de sistemas de inteligência artificial.
Governança não deve impedir inovação.
Ela permite que a empresa utilize IA com mais confiança.
O conhecimento precisa ter dono
Uma base inteligente pode encontrar informação rapidamente.
Mas ela não consegue decidir sozinha qual política comercial deveria ser considerada oficial se a própria empresa mantém cinco versões contraditórias.
Por isso, cada área precisa assumir responsabilidade pelo conhecimento que produz.
Financeiro deve cuidar das políticas financeiras.
Jurídico deve validar conteúdos jurídicos.
RH precisa manter procedimentos de pessoas atualizados.
Produto deve manter documentação técnica.
Comercial precisa registrar decisões e regras relevantes.
Essa mudança cultural é fundamental.
A McKinsey observou recentemente que organizações precisam transformar experiência em conhecimento codificado, incluindo frameworks, critérios de decisão, premissas, casos anteriores e julgamentos especializados. O objetivo não é simplesmente armazenar mais informação, mas tornar a melhor experiência da empresa utilizável e confiável.
Esse ponto é especialmente importante.
Uma base de conhecimento inteligente não deveria tratar todas as informações como igualmente valiosas.
A opinião isolada de um funcionário recém contratado e um procedimento validado durante anos não possuem necessariamente o mesmo peso.
Curadoria continua sendo necessária.
A empresa pode parar de depender tanto da memória das pessoas
Toda organização possui conhecimento informal.
É aquilo que normalmente aparece em frases como:
“Pergunta para o Carlos, ele sabe.”
“Só a Maria sabe fazer isso.”
“O João resolveu esse problema no ano passado.”
Essa dependência cria fragilidade.
Quando o profissional entra de férias, muda de área ou deixa a empresa, parte do conhecimento pode desaparecer.
Uma base inteligente permite transformar gradualmente esse conhecimento tácito em patrimônio organizacional.
Reuniões podem ser transcritas.
Decisões podem ser registradas.
Soluções podem entrar automaticamente na documentação.
Atendimentos podem alimentar FAQs.
Projetos concluídos podem gerar aprendizados.
Casos comerciais podem enriquecer a base.
O conhecimento deixa de morrer dentro das conversas e começa a formar uma espécie de memória corporativa acumulativa.
Vendas podem ganhar uma memória comercial poderosa
Imagine um vendedor preparando uma reunião com determinado cliente.
Em vez de abrir CRM, e mails, propostas, contratos e mensagens separadamente, ele pergunta:
“Resuma tudo o que aconteceu com esse cliente nos últimos doze meses e indique os principais pontos para a reunião de amanhã.”
A base consulta diferentes fontes.
Descobre negociações anteriores.
Localiza objeções.
Identifica produtos adquiridos.
Encontra problemas de suporte.
Analisa propostas.
Resume os principais pontos.
Um agente comercial poderia ir além.
Ele poderia utilizar essa informação para preparar uma proposta personalizada, criar argumentos, sugerir oportunidades adicionais e atualizar o CRM após a reunião.
Isso explica por que a base de conhecimento tende a se tornar infraestrutura fundamental para agentes de IA empresariais.
Sem conhecimento interno, o agente é inteligente, mas genérico.
Com acesso estruturado ao conhecimento, ele começa a compreender a empresa.
Atendimento pode responder melhor e mais rápido
Atendimento ao cliente é outro caso evidente.
Em muitas empresas, diferentes atendentes respondem à mesma pergunta de maneiras diferentes.
Alguns conhecem muito bem os procedimentos.
Outros precisam procurar a resposta.
Uma base inteligente pode recuperar políticas, documentação técnica, histórico do cliente e procedimentos internos em segundos.
A McKinsey aponta atendimento ao consumidor e gestão do conhecimento entre os usos importantes de sistemas RAG. O sistema pode recuperar informações corporativas relevantes e utilizar esses dados para construir respostas mais específicas.
Leia a explicação da McKinsey sobre RAG
O benefício não precisa significar substituir o atendente.
Pode significar dar a ele acesso imediato ao melhor conhecimento da empresa.
Onboarding pode passar de semanas para dias
Funcionários recém contratados enfrentam sempre o mesmo problema.
Precisam aprender sistemas, produtos, processos, clientes, regras e cultura organizacional.
Normalmente dependem de treinamentos, documentos e colegas mais experientes.
Com uma base inteligente, o novo funcionário pode conversar com o conhecimento da organização.
“Como fazemos uma proposta?”
“Quem aprova descontos superiores a 15%?”
“Como funciona nosso processo de desenvolvimento?”
“Quais são os principais produtos?”
“Existe algum caso parecido com esse?”
A McKinsey relatou em 2026 exemplos de empresas de tecnologia utilizando agentes de conhecimento capazes de indexar repositórios de código, Notion e conversas para acelerar a adaptação de novos funcionários.
Isso é muito mais poderoso do que simplesmente entregar uma pasta chamada Treinamento.
A próxima geração será formada por bases de conhecimento para agentes
Até agora falamos principalmente de humanos fazendo perguntas.
A próxima etapa será diferente.
As inteligências artificiais também consultarão a base.
Imagine um agente de vendas.
Antes de entrar em contato com um potencial cliente, ele consulta políticas comerciais, catálogo, casos anteriores, dados do CRM e histórico de conversas.
Um agente jurídico consulta contratos e normas.
Um agente financeiro verifica regras internas.
Um agente de suporte pesquisa documentação antes de responder.
Um agente de marketing consulta produtos, posicionamento, público e histórico de campanhas.
A base de conhecimento se transforma na memória operacional da inteligência artificial da empresa.
Esse movimento já aparece na evolução dos sistemas corporativos. A IBM observa que plataformas modernas de pesquisa empresarial estão incorporando IA generativa, RAG e agentes para consultar informações distribuídas entre diversos sistemas internos.
E a Microsoft já trabalha com recuperação por agentes, na qual o próprio sistema pode decompor uma pergunta complexa em várias consultas, executá las em diferentes fontes e reunir os resultados antes de produzir uma resposta.
Isso é uma mudança significativa.
Não estamos mais falando simplesmente de pesquisar documentos.
Estamos falando de máquinas utilizando conhecimento corporativo para raciocinar e agir.
O maior erro é simplesmente jogar todos os documentos dentro da IA
Existe uma falsa sensação de simplicidade nesse mercado.
Pegue 50 mil documentos.
Coloque tudo em um banco vetorial.
Conecte um modelo.
Pronto.
Não funciona assim.
Se houver documentos antigos, o modelo encontrará documentos antigos.
Se houver contradições, encontrará contradições.
Se informações fundamentais nunca foram registradas, não haverá nada para recuperar.
Se a fragmentação dos documentos estiver mal configurada, o contexto poderá ser perdido.
Se a pesquisa recuperar informações irrelevantes, a qualidade final cairá.
Se não houver permissões adequadas, a solução poderá expor dados sensíveis.
E se ninguém medir as respostas, os problemas continuarão invisíveis.
A qualidade de uma aplicação RAG depende fortemente da qualidade da preparação, recuperação e classificação da informação. AWS, Microsoft e Google dedicam grande parte de suas arquiteturas justamente à ingestão, divisão dos documentos, embeddings, recuperação, ranking e atualização das fontes.
A IA não elimina a necessidade de gestão do conhecimento.
Ela torna uma boa gestão do conhecimento ainda mais valiosa.
Como medir se a base realmente funciona?
O sucesso não deve ser medido pela quantidade de documentos indexados.
Uma empresa com dois milhões de arquivos e respostas ruins possui uma base pior do que outra com dez mil documentos altamente relevantes.
Indicadores melhores incluem:
tempo necessário para encontrar uma informação;
percentual de perguntas respondidas corretamente;
quantidade de respostas acompanhadas de fontes confiáveis;
redução de chamados internos;
tempo de treinamento de novos funcionários;
redução de documentos duplicados;
velocidade de preparação de propostas;
resolução no primeiro contato;
satisfação dos funcionários;
uso recorrente da plataforma;
economia de horas em tarefas de pesquisa.
O objetivo final não é construir uma biblioteca maior.
É reduzir a distância entre uma pergunta e uma decisão correta.
Pequenas empresas também podem criar sua inteligência corporativa
Talvez uma das maiores oportunidades esteja justamente nas pequenas e médias empresas.
Não é necessário possuir bilhões de documentos.
Uma pequena empresa pode conectar:
Google Drive;
Notion;
CRM;
site;
manuais;
base de clientes;
documentação de produtos;
atendimentos;
propostas;
procedimentos internos.
A camada inteligente pode ser construída sobre essas fontes sem obrigatoriamente migrar tudo para um único sistema.
Esse é um ponto interessante destacado pela McKinsey em sua análise de empresas nativas em IA: algumas organizações estão preferindo criar conectores que tornam o conhecimento consultável onde ele já está, em vez de obrigar todas as equipes a trabalhar dentro de uma única plataforma.
Isso reduz resistência.
A tecnologia encontra as pessoas onde elas trabalham.
A base de conhecimento pode se tornar o cérebro digital da empresa
Essa talvez seja a maneira mais interessante de pensar no assunto.
CRM guarda clientes.
ERP guarda operações.
Drive guarda arquivos.
Notion guarda documentação.
E mail guarda conversas.
Sistemas financeiros guardam transações.
Cada plataforma possui uma parte da empresa.
A base de conhecimento inteligente começa a criar uma camada capaz de compreender todas essas partes em conjunto.
Ela não precisa substituir os sistemas existentes.
Ela pode conectá los.
No futuro, agentes diferentes poderão compartilhar essa camada de conhecimento.
Um agente consulta.
Outro analisa.
Outro prepara uma ação.
Outro executa.
Outro monitora o resultado.
Nesse cenário, o conhecimento deixa de ser apenas um arquivo corporativo e passa a ser infraestrutura operacional da empresa.
O futuro da gestão do conhecimento será agêntico, multimodal e contínuo
As bases atuais trabalham predominantemente com textos.
Isso deve mudar rapidamente.
Vídeos de treinamento poderão ser pesquisados.
Reuniões poderão alimentar automaticamente o conhecimento.
Imagens poderão ser compreendidas.
Diagramas poderão ser interpretados.
Áudios poderão ser consultados.
Sistemas poderão combinar documentos, bancos relacionais, bancos vetoriais e grafos de conhecimento.
Agentes poderão realizar várias buscas antes de responder.
A própria arquitetura de recuperação está evoluindo. A Microsoft já apresenta recuperação por agentes como uma evolução da abordagem RAG convencional para perguntas complexas, enquanto o Google Cloud apresenta arquiteturas que combinam pesquisa vetorial e grafos.
A tendência aponta para bases cada vez menos passivas.
Elas poderão observar alterações, atualizar índices, detectar conflitos, recomendar novos documentos e identificar lacunas de conhecimento.
Conhecimento organizado pode se tornar vantagem competitiva
Durante muitos anos, empresas investiram em armazenar informação.
Agora precisarão aprender a transformá la em inteligência operacional.
Uma base de conhecimento inteligente não significa apenas instalar um chatbot.
Significa criar uma camada que conecta dados, documentos, pessoas, experiência, inteligência artificial e agentes.
Empresas capazes de fazer isso poderão responder clientes mais rapidamente, treinar funcionários em menos tempo, reduzir retrabalho, preservar conhecimento institucional e permitir que sistemas de inteligência artificial trabalhem com contexto real.
E talvez exista uma mudança ainda mais importante.
À medida que os grandes modelos se tornam amplamente disponíveis, possuir acesso ao melhor modelo pode deixar de representar uma vantagem competitiva duradoura.
O diferencial estará naquilo que o concorrente não possui:
seus dados, seus processos, sua experiência, seus clientes, suas decisões e o conhecimento acumulado durante anos de operação.
É exatamente aí que a base de conhecimento inteligente ganha importância estratégica.
O futuro da inteligência artificial empresarial provavelmente não será apenas perguntar:
“Qual modelo estamos utilizando?”
A pergunta mais importante poderá ser:
“O que nossa inteligência artificial sabe sobre a nossa própria empresa?”
E para muitas organizações, a resposta a essa pergunta poderá separar aquelas que simplesmente utilizam IA daquelas que realmente conseguem transformar conhecimento em produtividade, decisão e crescimento.